
NCM: uma nova abordagem para geração de texto com inteligência artificial
Pesquisa de Stanford e da Together AI propõe gerar textos de forma hierárquica e paralela, com ganhos de velocidade em experimentos.
Em outubro de 2026, pesquisadores da Universidade Stanford e da Together AI apresentaram o Next-Concept Modeling (NCM), uma abordagem para geração de texto. O trabalho foi disponibilizado no arXiv em 9 de outubro [1].
Nos modelos de linguagem autorregressivos, cada novo token é produzido a partir dos anteriores. Essa dependência sequencial limita o paralelismo durante a geração [1].
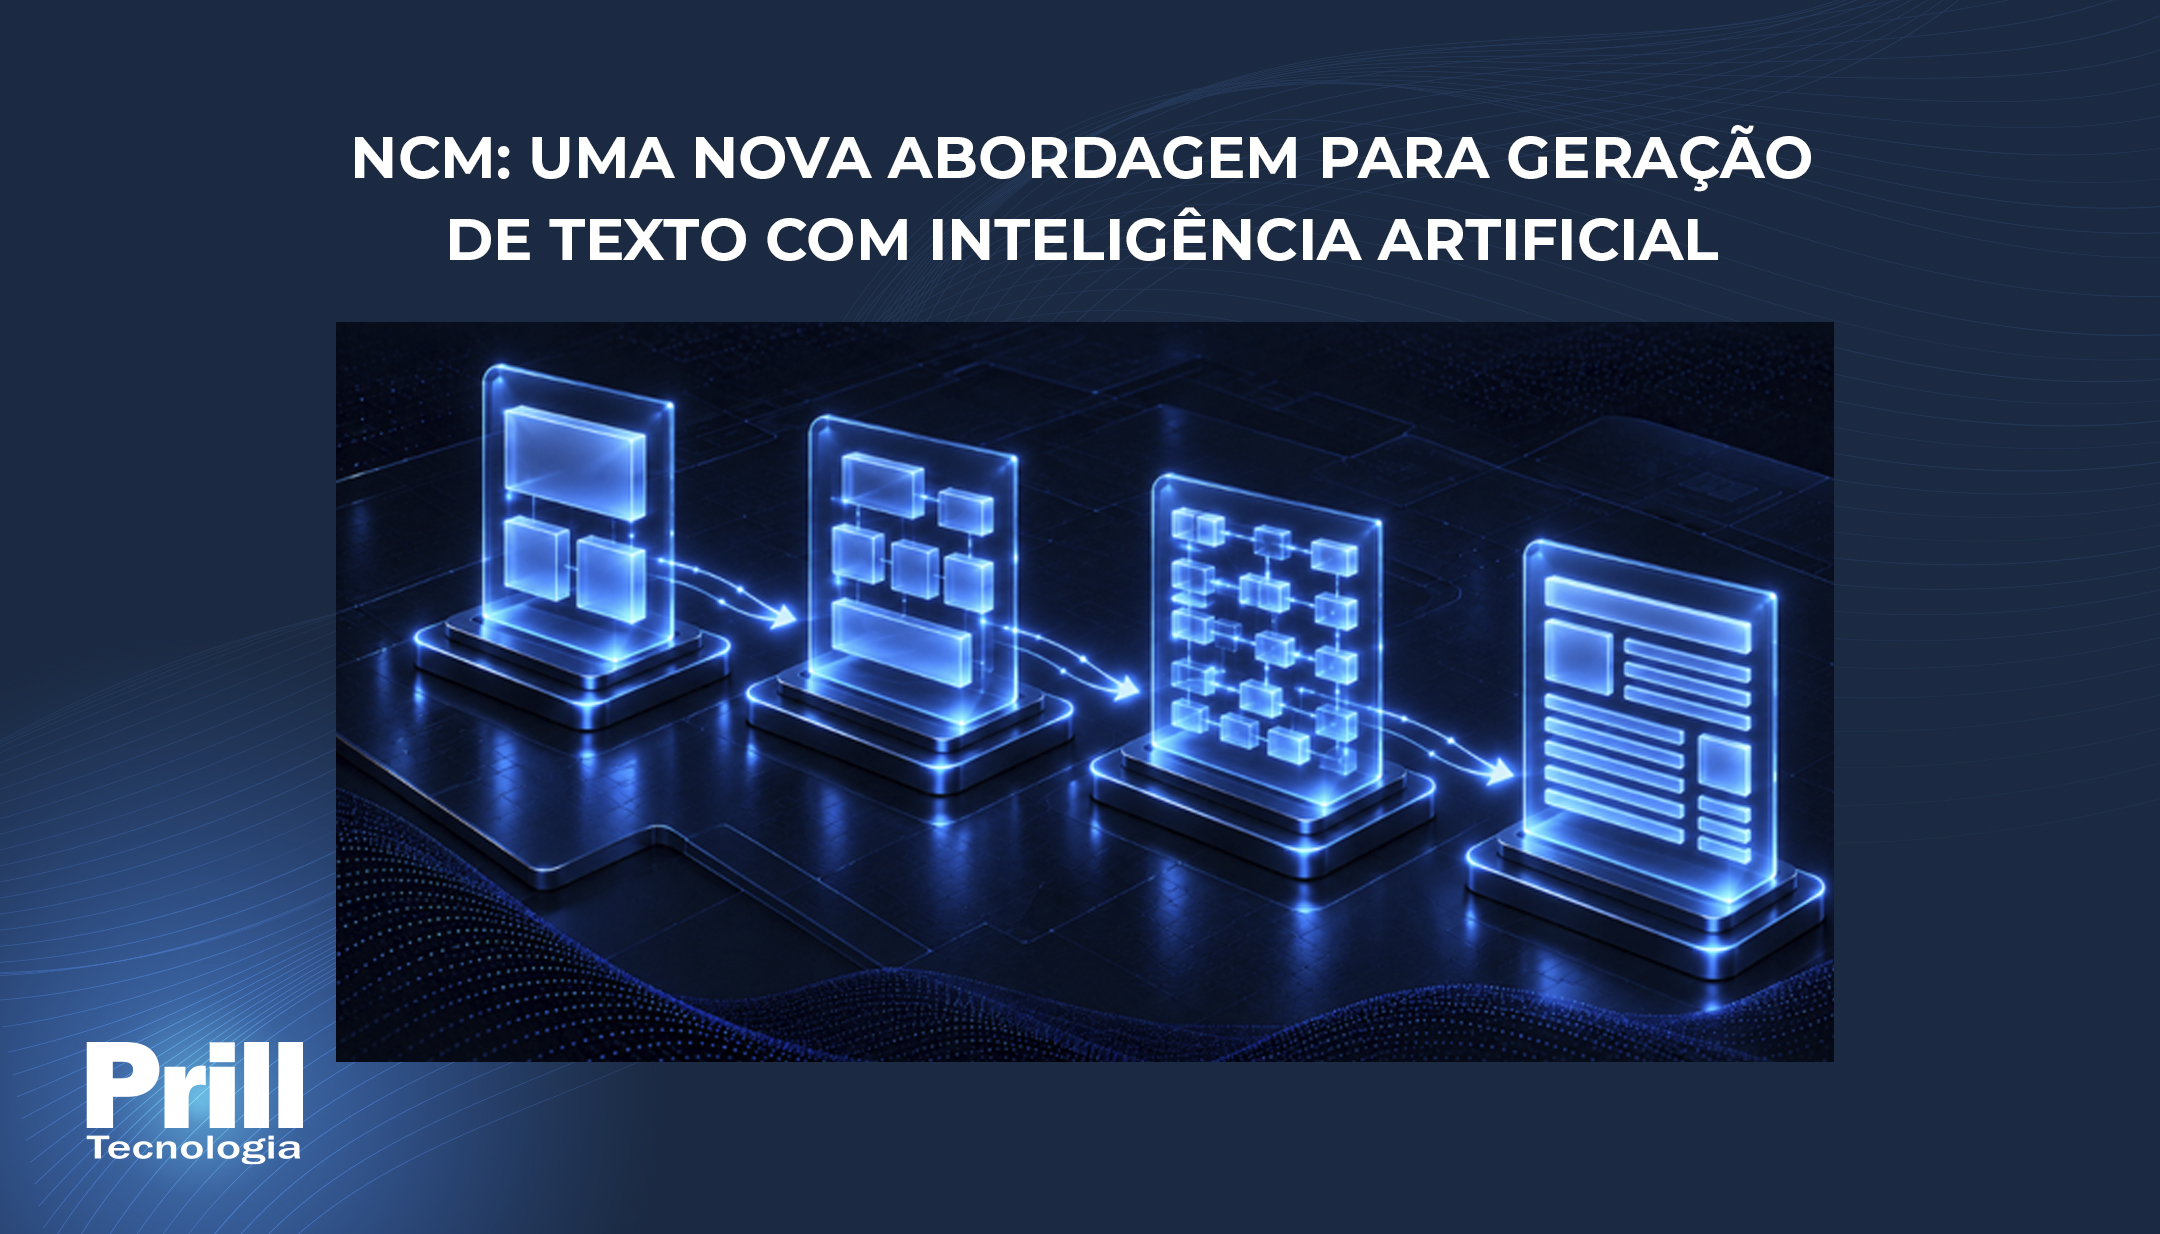
O NCM propõe gerar representações progressivamente mais detalhadas do texto, com processamento paralelo dentro de cada nível [2].
Como funciona o NCM?
Durante o treinamento, um tokenizador multiescala aprende a representar o texto como uma hierarquia de códigos discretos. Um Transformer é então treinado para gerar essa hierarquia, do geral para o detalhado [3].
Na geração, os níveis são produzidos sucessivamente, mas os códigos de cada nível são previstos em paralelo. Ao final, um decodificador converte a representação acumulada em texto [2, 3].
O termo conceito refere-se à informação representada nos níveis mais gerais dessa hierarquia. São representações aprendidas pelo modelo, sem correspondência obrigatória com ideias ou frases identificáveis por humanos [1].
Quais são os resultados?
Segundo os pesquisadores [2], o NCM apresentou os seguintes ganhos de velocidade em relação aos modelos de linguagem por difusão usados como referência:
- 21 vezes mais rápido no LM1B, com melhor perplexidade generativa.
- 10 vezes mais rápido no OpenWebText, com perplexidade generativa comparável.
- 31 vezes mais rápido na sumarização XSum, com resultado comparável na métrica ROUGE-L.
Os resultados de qualidade se referem às métricas utilizadas nos testes. A própria equipe ressalta que a perplexidade generativa não captura integralmente a qualidade dos textos, ou seja, uma pontuação melhor nessa métrica não garante que o conteúdo seja mais útil, factualmente correto ou variado [1, 2].
As medições de tempo foram realizadas em uma GPU NVIDIA H100 SXM de 80 GB, nas condições experimentais descritas pelos autores [2]. Esses números não representam uma comparação direta com sistemas comerciais como GPT, Claude ou Gemini.
O código da implementação de referência está disponível publicamente no GitHub [3].
O NCM pode substituir os LLMs?
NCM e LLM descrevem aspectos diferentes: LLM significa modelo de linguagem de grande escala, enquanto NCM designa uma abordagem de representação e geração. Em termos conceituais, portanto, não são categorias mutuamente excludentes.
Os resultados ainda se limitam ao escopo experimental do estudo. Os principais experimentos usaram geradores com aproximadamente 100 milhões de parâmetros, e a avaliação de escala no LM1B chegou a 725 milhões. Os autores apontam a expansão para modelos e conjuntos de dados maiores como trabalho futuro [1].
A contribuição demonstrada é a redução das etapas sequenciais de geração nos cenários avaliados. Sua competitividade em sistemas de uso geral e em escalas maiores permanece uma questão de pesquisa [1].
Glossário
Código discreto: identificador selecionado de um conjunto finito de representações aprendidas pelo modelo. No NCM, esses códigos formam a hierarquia usada para representar e gerar o texto.
Decodificador: componente que transforma uma representação interna do modelo em uma saída. No NCM, converte a representação acumulada nos diferentes níveis em tokens de texto.
DLM (Diffusion Language Model): modelo de linguagem por difusão. Gera texto por etapas de refinamento, removendo ruído ou preenchendo posições mascaradas, com possibilidade de atualizar várias posições em paralelo.
Geração autorregressiva: processo em que cada novo token é gerado com base nos tokens anteriores.
GPU (Graphics Processing Unit): processador especializado na execução de muitas operações em paralelo, utilizado para acelerar o treinamento e a execução de modelos de inteligência artificial.
LLM (Large Language Model): modelo de linguagem de grande escala, treinado para aprender padrões da linguagem e realizar tarefas como geração de texto.
LM1B (One Billion Word): conjunto de textos utilizado como referência para treinamento e avaliação de modelos de linguagem.
NCM (Next-Concept Modeling): abordagem que gera texto por meio de uma hierarquia de representações, do geral para o detalhado, prevendo os códigos de cada nível em paralelo.
OpenWebText: conjunto de textos obtidos da web, utilizado no estudo para avaliar a geração de linguagem.
Parâmetros: valores numéricos ajustados durante o treinamento que determinam como o modelo processa informações e produz suas saídas.
Perplexidade generativa: medida calculada ao avaliar textos gerados com um modelo de linguagem de referência. Valores menores indicam que esses textos são mais previsíveis para o avaliador, mas não garantem, isoladamente, maior qualidade ou diversidade.
ROUGE-L: métrica que compara um texto gerado com um texto de referência pela maior subsequência de palavras em comum, preservando sua ordem, sem exigir que sejam consecutivas. É utilizada na avaliação de resumos.
Token: unidade de representação de texto processada pelo modelo. Pode corresponder a uma palavra, parte de uma palavra ou sinal de pontuação, conforme o tokenizador.
Tokenizador multiescala: no NCM, componente que aprende a representar o texto em níveis com diferentes graus de detalhamento, organizados em uma hierarquia de códigos discretos.
Transformer: arquitetura de rede neural que utiliza mecanismos de atenção para relacionar informações entre posições de uma sequência.
XSum (Extreme Summarization): conjunto de artigos jornalísticos acompanhados de resumos curtos de referência, utilizado para treinar e avaliar sistemas de sumarização.
Pesquisadores
Hermann Kumbong é doutorando em Ciência da Computação na Universidade Stanford, onde também concluiu seu mestrado. É de Bamenda, em Camarões, e graduou-se em Engenharia da Computação pela Kwame Nkrumah University of Science and Technology [4].
Sua pesquisa busca desenvolver métodos eficientes para construir e executar sistemas de inteligência artificial e ampliar o acesso à tecnologia. Integra a turma de 2025 do programa Knight-Hennessy Scholars [4] e o grupo Hazy Research, em Stanford [5].
Ishan S. Khare é mestrando em Ciência da Computação na Universidade Stanford, onde também concluiu sua graduação. Desenvolve pesquisas com Christopher Ré, no Hazy Research Lab, e Azalia Mirhoseini, no Scaling Intelligence Lab [6].
Seu trabalho concentra-se nas limitações computacionais e nos princípios de funcionamento de sistemas de aprendizado de máquina, buscando modelos mais eficientes e capazes. Participou de pesquisas como Smoothie, sobre seleção de modelos de linguagem, e WONDERBREAD, sobre avaliação de modelos multimodais em processos empresariais [6].
Kumbong e Khare compartilham a autoria principal do estudo sobre NCM, com contribuições equivalentes. A pesquisa reúne nove autores ligados a Stanford e à Together AI. Simran Arora, Azalia Mirhoseini e Christopher Ré compartilham a orientação científica, conforme indicado pela equipe [1, 2].
Sobre o autor
Jorge Ramos
Engenheiro de Software | Prill Tecnologia
Referências
[1] H. Kumbong et al., “Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation,” arXiv, arXiv:2610.14162, versão 1, 9 out. 2026. DOI: 10.48550/arXiv.2610.14162.
[2] H. Kumbong et al., “Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation,” Hazy Research, 12 out. 2026. Acesso em: 2 nov. 2026.
[3] Hazy Research, “NCM: implementação de referência,” GitHub. Acesso em: 2 nov. 2026.
[4] Stanford University, “Hermann Kumbong,” Knight-Hennessy Scholars. Acesso em: 2 nov. 2026.
[5] Hazy Research, “People.” Acesso em: 2 nov. 2026.
[6] I. S. Khare, “Página pessoal e publicações acadêmicas.” Acesso em: 2 nov. 2026.
[7] C.-Y. Lin, “ROUGE: A Package for Automatic Evaluation of Summaries,” in Text Summarization Branches Out. Association for Computational Linguistics, 2004, p. 74 a 81.
[8] A. Vaswani et al., “Attention Is All You Need,” arXiv, arXiv:1706.03762, 2017. DOI: 10.48550/arXiv.1706.03762.